
Jev: quando a IA sabe que não sabe
O modelo da TypeSafe produz respostas estruturadas com probabilidades e níveis de confiança. A proposta ajuda a encaminhar casos incertos, mas confiança não é garantia de acerto.
Cleber Zanchettin
PESQUISADOR
Neste artigo
- 01O Jev retorna escolhas, pontuações e probabilidades, em vez de gerar explicações longas em texto livre.
- 02Segundo a TypeSafe, o modelo produz essas saídas em paralelo e é treinado para fornecer probabilidades calibradas.
- 03Casos de baixa confiança podem ser encaminhados para um modelo mais poderoso ou para revisão humana.
- 04Os limiares precisam ser validados por tarefa, e um avaliador automatizado não deve ser o único árbitro em decisões críticas.
Em evidência desde a última semana, o Jev, que, ao contrário do que muitos pensam, não é uma sigla, vem do nome de William Stanley Jevons, economista britânico associado ao chamado Paradoxo de Jevons. A ideia é que, quando uma tecnologia se torna muito mais eficiente e barata, seu uso pode aumentar tanto que o consumo total cresce, em vez de diminuir. A analogia é que quanto mais barato ficar “comprar inteligência”, no caso, inteligência artificial, mais aplicações surgirão.
Na prática, o Jev é um avaliador de respostas de IA que toma uma decisão diretamente, em vez de usar um LLM generativo para produzir uma explicação longa e depois chegar ao veredito. Ele não substitui o LLM ou suas análises, ele é um modelo de IA projetado não para gerar texto livre, mas para tomar decisões estruturadas que possam ser usadas diretamente por software. Apesar da evolução que tivemos, fazer um LLM funcionar de forma autônoma, segura e confiável entre diferentes aplicações ainda é um desafio.
Em vez de receber uma pergunta e produzir uma resposta token a token, como um LLM tradicional, ele recebe um estado ou contexto e um conjunto previamente definido de perguntas ou opções de decisão. Para cada uma, retorna um valor estruturado, por exemplo, sim/não, uma escolha entre alternativas ou uma pontuação, acompanhado de uma distribuição de probabilidades e de um nível de confiança.
Segundo a TypeSafe, empresa que lançou o Jev, essas decisões são produzidas em paralelo, em vez de por geração autoregressiva sequencial, e o modelo é treinado especificamente para fornecer probabilidades calibradas. Isso permite que um sistema use o Jev como uma espécie de “if inteligente”: decisões de alta confiança podem ser executadas automaticamente, enquanto casos de baixa confiança podem ser encaminhados para um LLM mais poderoso ou para revisão humana.
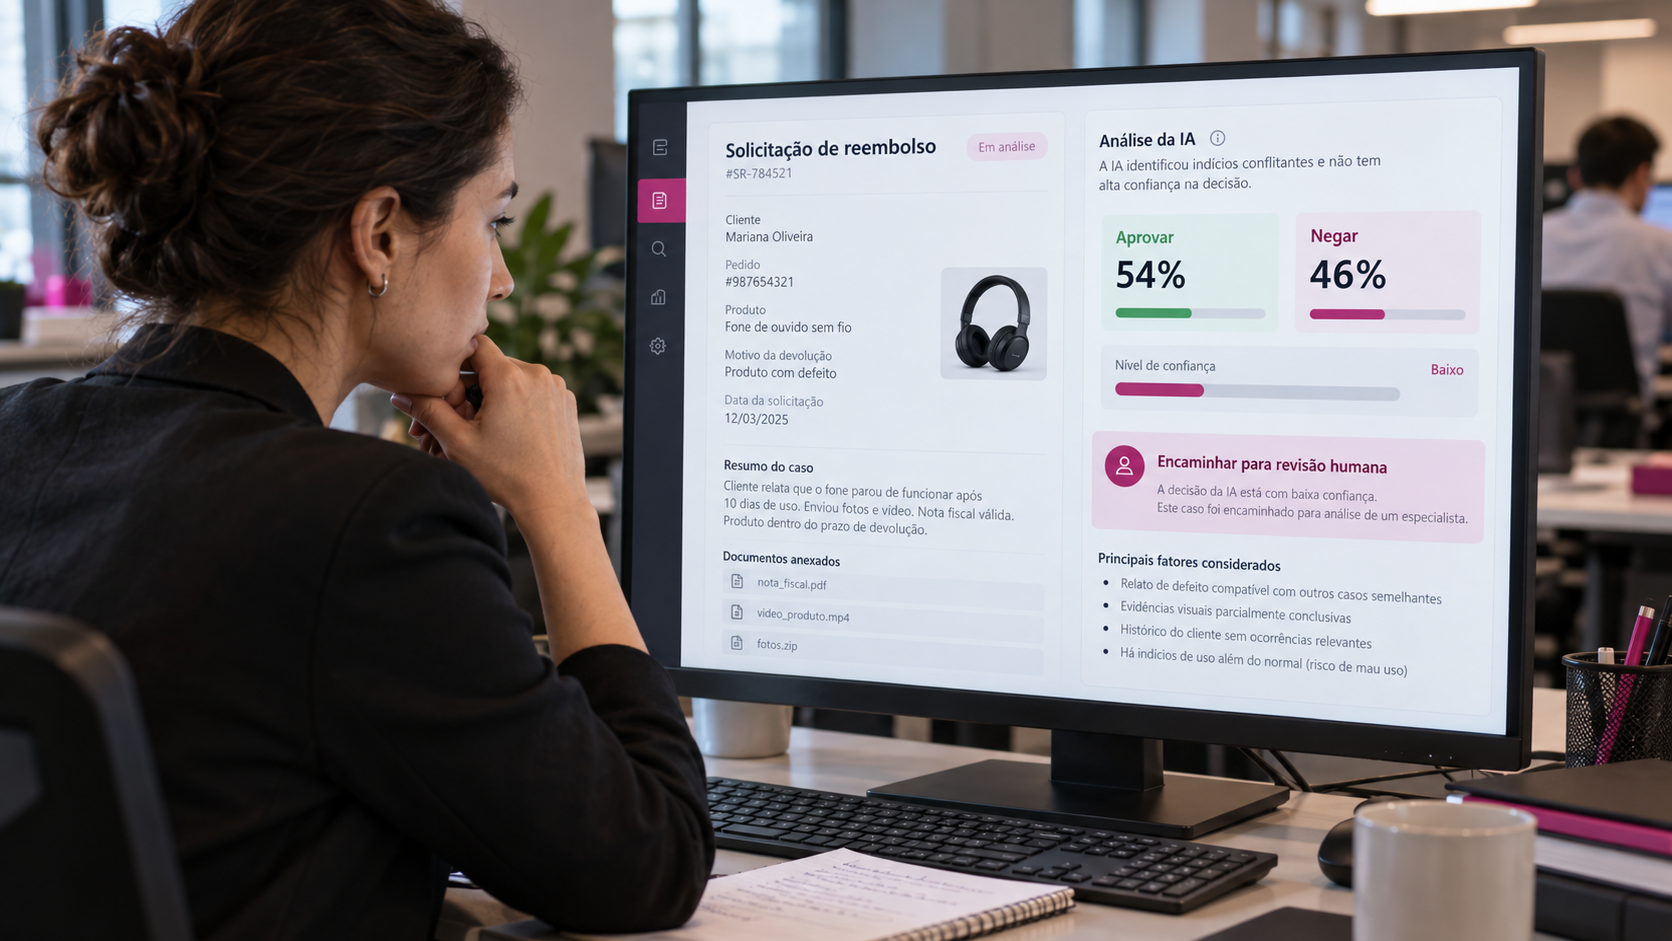
Quer um exemplo? Imagine uma loja online que recebe milhares de pedidos de reembolso. Um cliente escreve: “O produto chegou quebrado, segue a foto, recebi ontem.” O sistema entrega ao Jev a mensagem do cliente e as regras da loja. Em vez de escrever uma longa explicação, o Jev responde algo como: “Aprovar reembolso: 97%; negar: 3%.” Como a confiança é alta, o sistema aprova automaticamente. Agora imagine outro pedido: “Não gostei muito do produto e talvez queira devolver, mas já usei algumas vezes.” O Jev pode responder: “Aprovar: 54%; negar: 46%.” Como está inseguro, ele não decide sozinho: encaminha o caso para um modelo mais sofisticado ou para uma pessoa.
O Jev não tenta conversar sobre o problema, ele tenta escolher entre decisões possíveis e dizer o quanto está seguro da escolha. Mas, e sempre tem um mas, a confiança não deve ser tratada como “garantia de correção”. Em tarefas complexas ou quando o modelo é induzido por respostas erradas, porém bem escritas, ele pode estar confiante e ainda assim errar. Por isso a recomendação é validar os limiares por tarefa e evitar usar um juiz automatizado como único árbitro em decisões críticas.
Talvez o próximo salto da IA não seja saber mais, mas saber melhor quando não sabe.
Perguntas frequentes
Fontes
- 1.TypeSafe · Empresa citada no material como responsável pelo lançamento do Jev e pelas afirmações sobre saídas em paralelo e treinamento para probabilidades calibradas.
Continue lendo
 Artigo
Deep tech · Saúde · Seguros · Financeiro · Energia · Indústria
Do pixel à decisão: seis pesquisas apoiadas pela Di2win no SIBGRAPI 2026
Desenvolvidos por pesquisadores da UPE com apoio da Di2win, os estudos investigam reconhecimento de escrita, interpretação de documentos e eficiência de modelos, com atenção aos limites entre laboratório e aplicação.
02 de out. de 2026 · 4 min de leitura
 Artigo
Deep tech · Saúde
Do pixel à decisão | Di2win no SIBGRAPI 2026
Seis estudos da Universidade de Pernambuco, com apoio da Di2win, apresentados no SIBGRAPI 2026. Aqui, cada estudo tem duas leituras: para quem decide e para quem constrói.
Di2win30 de set. de 2026 · 24 min de leitura
 Na imprensa
Decisões críticas · Saúde
Pernambuco multiplica por 16 os pedidos de ressarcimento da Saúde com IDP da Di2win
Tecnologia de Processamento Inteligente de Documentos leva a Secretaria de Saúde de Pernambuco de 276 para 4.506 processos enviados por mês ao Ministério da Saúde, com projeção de R$ 780 milhões em recuperação.
Redação Di2win16 de jul. de 2026 · 4 min de leitura