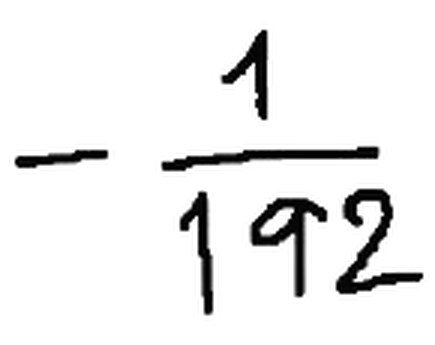
Uma vírgula fora do lugar muda o sentido de uma guia médica.
46,52%
das linhas de texto médico manuscrito foram transcritas sem nenhum erro pelo melhor modelo testado. Mais da metade tem pelo menos um erro.
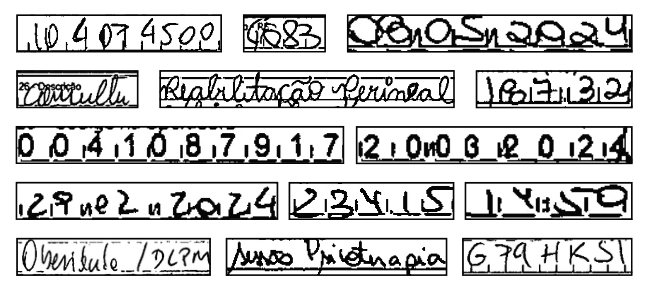
- O que o estudo entrega
- Um conjunto público com 13.916 linhas manuscritas, extraídas de guias SADT reais e anonimizadas, e uma comparação de seis modelos de reconhecimento de letra manuscrita nas mesmas condições.
- O que muda no negócio
- Para operadoras, hospitais e auditorias, saber campo a campo onde a máquina acerta e onde ainda erra é o que permite automatizar com responsabilidade, aceitando o que é confiável e levando à revisão humana o que não é.
- Onde o humano decide
- Em valores e texto médico, um separador decimal ou um dígito trocado muda o sentido. Nesses campos, a máquina enxerga e o humano decide.
Guia SADT · formulário do padrão TISS usado para solicitar e cobrar exames e terapias entre prestadores e operadoras de saúde.
Por que o conjunto existe
Benchmarks públicos de reconhecimento de texto manuscrito (HTR) raramente capturam a variabilidade de registros clínicos reais, e restrições de privacidade limitam o acesso a dados de saúde representativos.
Como foi construído
- Formulários clínicos reais, coletados em fluxos de rotina
- Remoção dos campos com dados pessoais
- Segmentação semiautomática das linhas de texto
- Validação manual das transcrições
- Partições estratificadas fixas de 80/10/10
Composição
13.916 linhas de texto, por tipo de campo
Benchmark: seis arquiteturas, mesmas partições
| Modelo | Paradigma | Parâmetros | CER | WER |
|---|---|---|---|---|
| Bluche | CRNN com portas | 0,73M | 16,89 | 40,45 |
| FLOR | CRNN | 0,83M | 8,90 | 23,52 |
| FLOR-V2 | CRNN aprimorada | 1,70M | 8,23 | 21,22 |
| HTR-VT | Vision Transformer | 59,16M | 9,00 | 19,24 |
| Puigcerver | CRNN | 9,60M | 11,64 | 29,92 |
| Puig. + Octave | CRNN + OctConv | 9,85M | 17,82 | 40,31 |
CER e WER no conjunto de teste, em %. Menor é melhor. Em destaque, o melhor de cada coluna.
Achados
- Texto médico é a categoria mais difícil: o melhor modelo chega a 46,52% de acerto exato, reflexo de letra irregular e vocabulário sem restrição.
- No nível de caractere, o FLOR-V2, com 1,70 milhão de parâmetros, superou o HTR-VT, com 59,16 milhões. No nível de palavra, o HTR-VT venceu.
- Paradigmas diferentes se saem melhor em tipos de campo diferentes, e a métrica agregada esconde essas diferenças.
O que os erros revelam
- Valores
- Separadores decimais e trocas de dígitos podem mudar o sentido clínico.
- Identificadores
- Letras confundidas com dígitos visualmente parecidos.
- Texto médico
- Distorções lexicais, omissões e erros de espaçamento continuam frequentes.
Próximos passos
O conjunto sustenta trabalhos futuros em adaptação de domínio, modelos de fundação e síntese realista de manuscritos.
Jogue contra a máquina
Onde a máquina mais acerta?
Você já viu onde ela mais erra. Agora escolha, entre os seis tipos de campo das guias, aquele em que você acha que o melhor modelo mais acerta.
Entre o campo mais bem lido e o mais difícil há 44 pontos de diferença. A média esconde isso, e a automação precisa ser desenhada campo a campo.
Melhor acerto exato por categoria entre as seis arquiteturas avaliadas, no conjunto de teste.
Créditos
AutoresPedro Rocha, Arthur F. S. Neto e Byron Leite Dantas Bezerra
InstituiçãoUniversidade de Pernambuco (UPE)
ApoioCAPES (código de financiamento 001), UPE e Di2win
Artigo e dadosdoi.org/10.5281/zenodo.22117865